Die Beispielfirma: bulb-tech
Damit das Team echte Arbeit bekommt, habe ich eine komplette Firma erfunden: bulb-tech, ein fiktives Start-up für Smart Energy. Es verkauft Ladestationen fürs Elektroauto (Wallboxen) und Batteriespeicher für Solarstrom. Die Geräte sprechen miteinander und über ein kleines Gateway mit der Cloud. Ihre Gerätesoftware stammt von einem ebenfalls erfundenen Lieferanten namens Talvix.
Wie bei einer echten Firma melden sich Kunden beim Support, wenn etwas nicht funktioniert: Das Auto lädt nicht, der Speicher meldet sich nicht mehr, der Stromverbrauch wirkt seltsam. Genau diese Tickets bearbeitet das KI-Team.
Zur Firma gehört alles, was ein Support-Team im Alltag braucht – bewusst so gebaut, dass es das System fordert:
- ein eigenes Jira-Board mit Support-Tickets und ein separates Fehler-Board des Lieferanten,
- Gerätespezifikationen pro Firmware-Version in einer PostgreSQL-Datenbank,
- generierte Logfiles mit versteckten Auffälligkeiten,
- und absichtlich gemeine Tickets, die das Team beim Raten ertappen sollen.
Die Ausgangslage: Tickets einordnen kostet Zeit
Die Idee stammt aus der Praxis im technischen Support. Bevor ein Spezialisten-Team ein Ticket bearbeiten kann, muss jemand entscheiden, wohin es gehört: Liegt es an der Wallbox oder am Batteriespeicher? Gibt es dazu schon einen bekannten Firmware-Fehler? Steht im Logfile etwas Auffälliges? Diese Einordnung passiert vielerorts von Hand, Ticket für Ticket.
Genau diesen Schritt wollte ich automatisieren – mit einem klaren Anspruch: Eine KI, die Tickets einordnet, darf nicht raten. Sprachmodelle klingen auch dann überzeugend, wenn sie falsch liegen. Und ein überzeugend formuliertes Fehlurteil schickt ein Team in die falsche Richtung.
Spezialisten statt Alleskönner
Deshalb arbeitet hier nicht eine einzige grosse KI, sondern ein Team. Für mich sind die Agenten tatsächlich wie Teammitglieder: Jedes hat eine klare Rolle, nur die Werkzeuge, die es dafür braucht – und feste Regeln, was es unter keinen Umständen tun darf.
Übergeben wird in einem strengen Format: Jeder Agent antwortet mit einem strukturierten Datensatz statt mit Fliesstext. Was nicht ins vorgegebene Schema passt, fällt auf.
Das Team
Sechs Rollen, zwei Stufen: Der Pförtner sortiert neue Tickets vor. Für die Tiefenanalyse übernimmt das Kernteam – vom Aufbereiter bis zum skeptischen Chef.
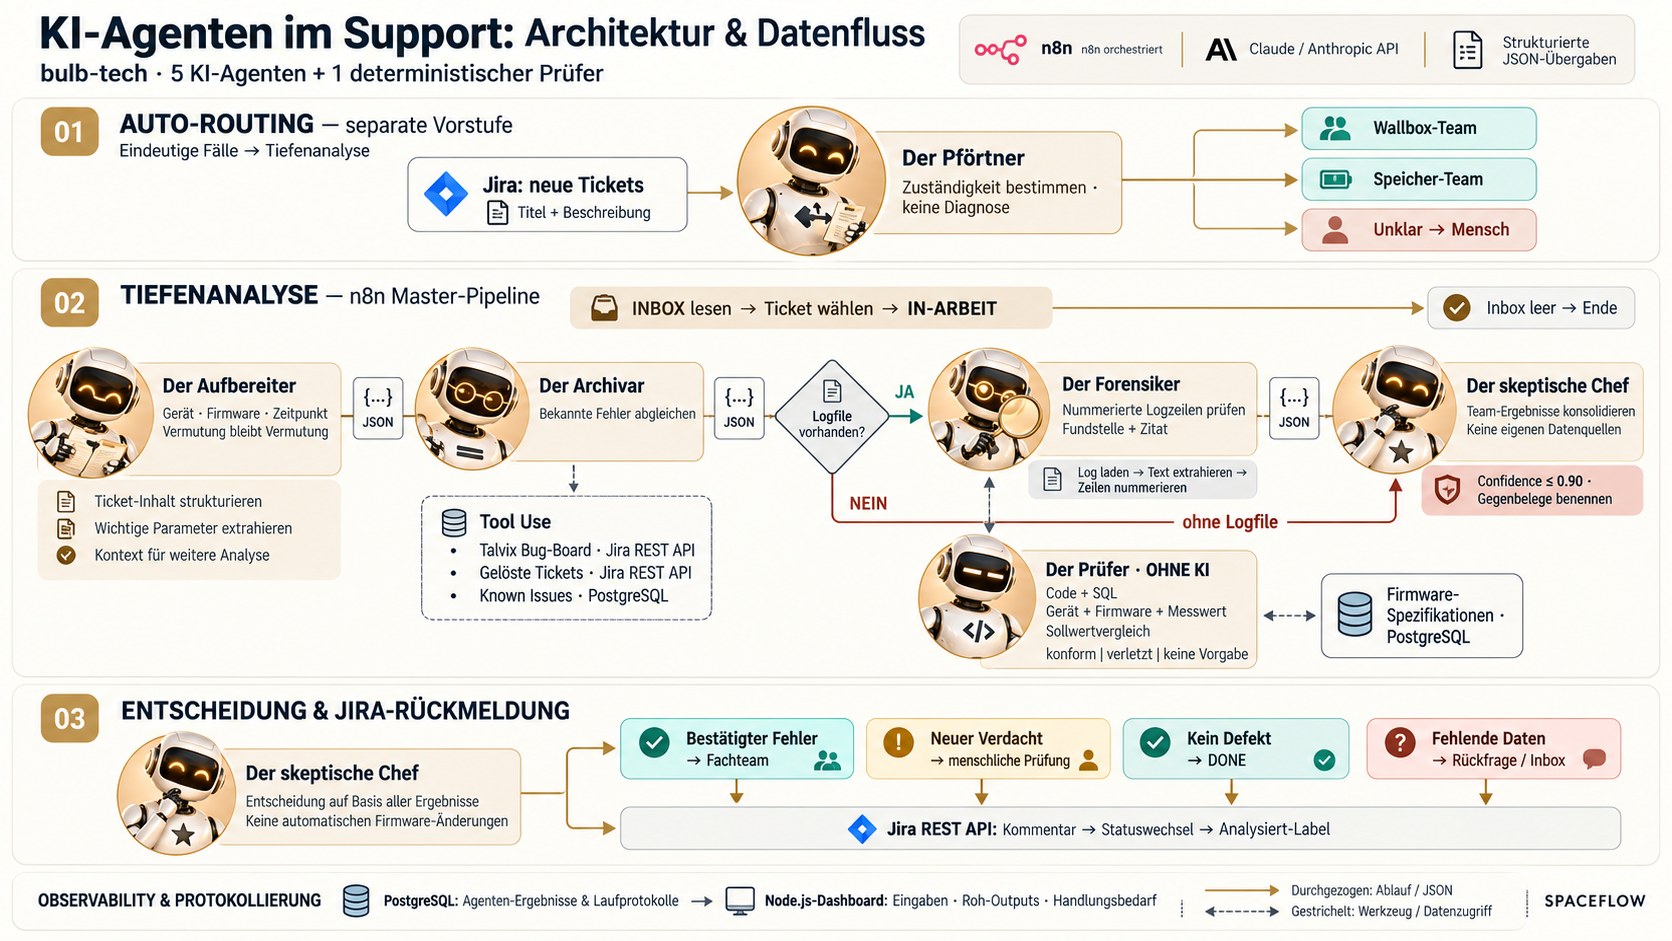
Der Pförtner
- Auftrag
- Entscheidet, welches Team zuständig ist – Speicher, Wallbox oder «unklar».
- Sieht
- Nur Titel und Beschreibung des Tickets.
- Darf nicht
- Ursachen nennen oder raten. Ist ein Ticket nicht eindeutig, bleibt es für einen Menschen liegen.
Der Aufbereiter
- Auftrag
- Macht aus dem rohen Ticket eine saubere Arbeitsgrundlage: Gerät, Firmware, Zeitpunkt, offene Punkte.
- Sieht
- Das Ticket – und nur das, was wörtlich darin steht.
- Darf nicht
- Lücken füllen oder eine Vermutung des Supports zur Tatsache machen. Sie wird bis zum Schluss als Vermutung mitgeführt.
Der Archivar
- Auftrag
- Prüft, ob der Fehler schon bekannt ist.
- Sieht
- Das Fehler-Board des Firmware-Lieferanten, gelöste Tickets und eine interne Datenbank bekannter Fehler.
- Darf nicht
- Eine Fehlernummer nennen, die seine Werkzeuge nicht tatsächlich geliefert haben. Passt nichts eindeutig, lautet die Antwort: nicht bekannt.
Der Forensiker
- Auftrag
- Sucht im Logfile des Geräts nach Auffälligkeiten rund um den Vorfall.
- Sieht
- Das Logfile mit nummerierten Zeilen – und den Prüfer.
- Darf nicht
- Etwas melden ohne Zeilennummer und zitierte Logzeile. Und Sollwerte nie aus dem Gedächtnis nehmen, sondern immer den Prüfer fragen.
Der Prüfer
- Auftrag
- Vergleicht Messwerte mit der Spezifikation des jeweiligen Geräts und der Firmware-Version.
- Sieht
- Die Spezifikationen in der Datenbank.
- Darf nicht
- Interpretieren. Er ist reiner Code – seine Antwort lautet «konform», «verletzt» oder «keine Vorgabe gefunden».
Der skeptische Chef
- Auftrag
- Führt alle Ergebnisse zusammen und fällt das Urteil: bestätigter Fehler, neuer Verdacht, kein Defekt – oder es fehlen Daten.
- Sieht
- Ausschliesslich die Resultate seines Teams, bewusst ohne eigene Datenquellen.
- Darf nicht
- Widersprüche glattbügeln oder sich ganz sicher sein. Seine Zuversicht ist auf 90 % gedeckelt, und er nennt, was sein Urteil kippen würde.
Der wichtigste Kollege hat keine KI
Ob ein Lebenszeichen alle 180 Sekunden zwischen Speicher und Ladestation ein Fehler ist, hängt von der Firmware ab: Bei der einen Version sind 30 Sekunden vorgegeben, bei der anderen 60. Solche Nachschlage-Aufgaben einem Sprachmodell zu überlassen, wäre genau die Fehlerquelle, die ich ausschliessen wollte.
Deshalb rechnet der Prüfer, statt zu raten: Spezifikation aus der Datenbank lesen, Ist- mit Sollwert vergleichen, Ergebnis zurückgeben. Das lässt sich live zeigen: Ändere ich den Sollwert in der Datenbank von 30 auf 300 Sekunden und lasse dieselbe Pipeline erneut laufen, kippt das Urteil von «bestätigter Fehler» zu «kein Defekt feststellbar». Das Team folgt den Daten – nicht einer einmal gefassten Meinung.
Der Praxistest: Fallen stellen
- Ein Ticket klagt seitenlang über die Wallbox, die Symptome zeigen aber auf den Speicher, der sie versorgt → das Team routet gegen den Wortlaut richtig und begründet warum.
- Dasselbe in die Gegenrichtung → ebenfalls richtig.
- Ein bewusst vages Ticket («Stromverbrauch irgendwie hoch») → das Team routet nicht, sondern meldet «unklar, bitte manuell zuordnen».
- Symptome passen zu einem bekannten Fehler, aber Logfile und Firmware-Angabe fehlen → das Team bestätigt den Fehler nicht, sondern fragt die fehlenden Daten nach.
Gerade die letzten beiden Fälle waren mir am wichtigsten. Dass ein System richtig liegt, wenn alles eindeutig ist, beeindruckt wenig. Dass es nicht antwortet, wenn es nicht antworten kann – das war das Ziel.
Zusammenarbeit auf dem Board
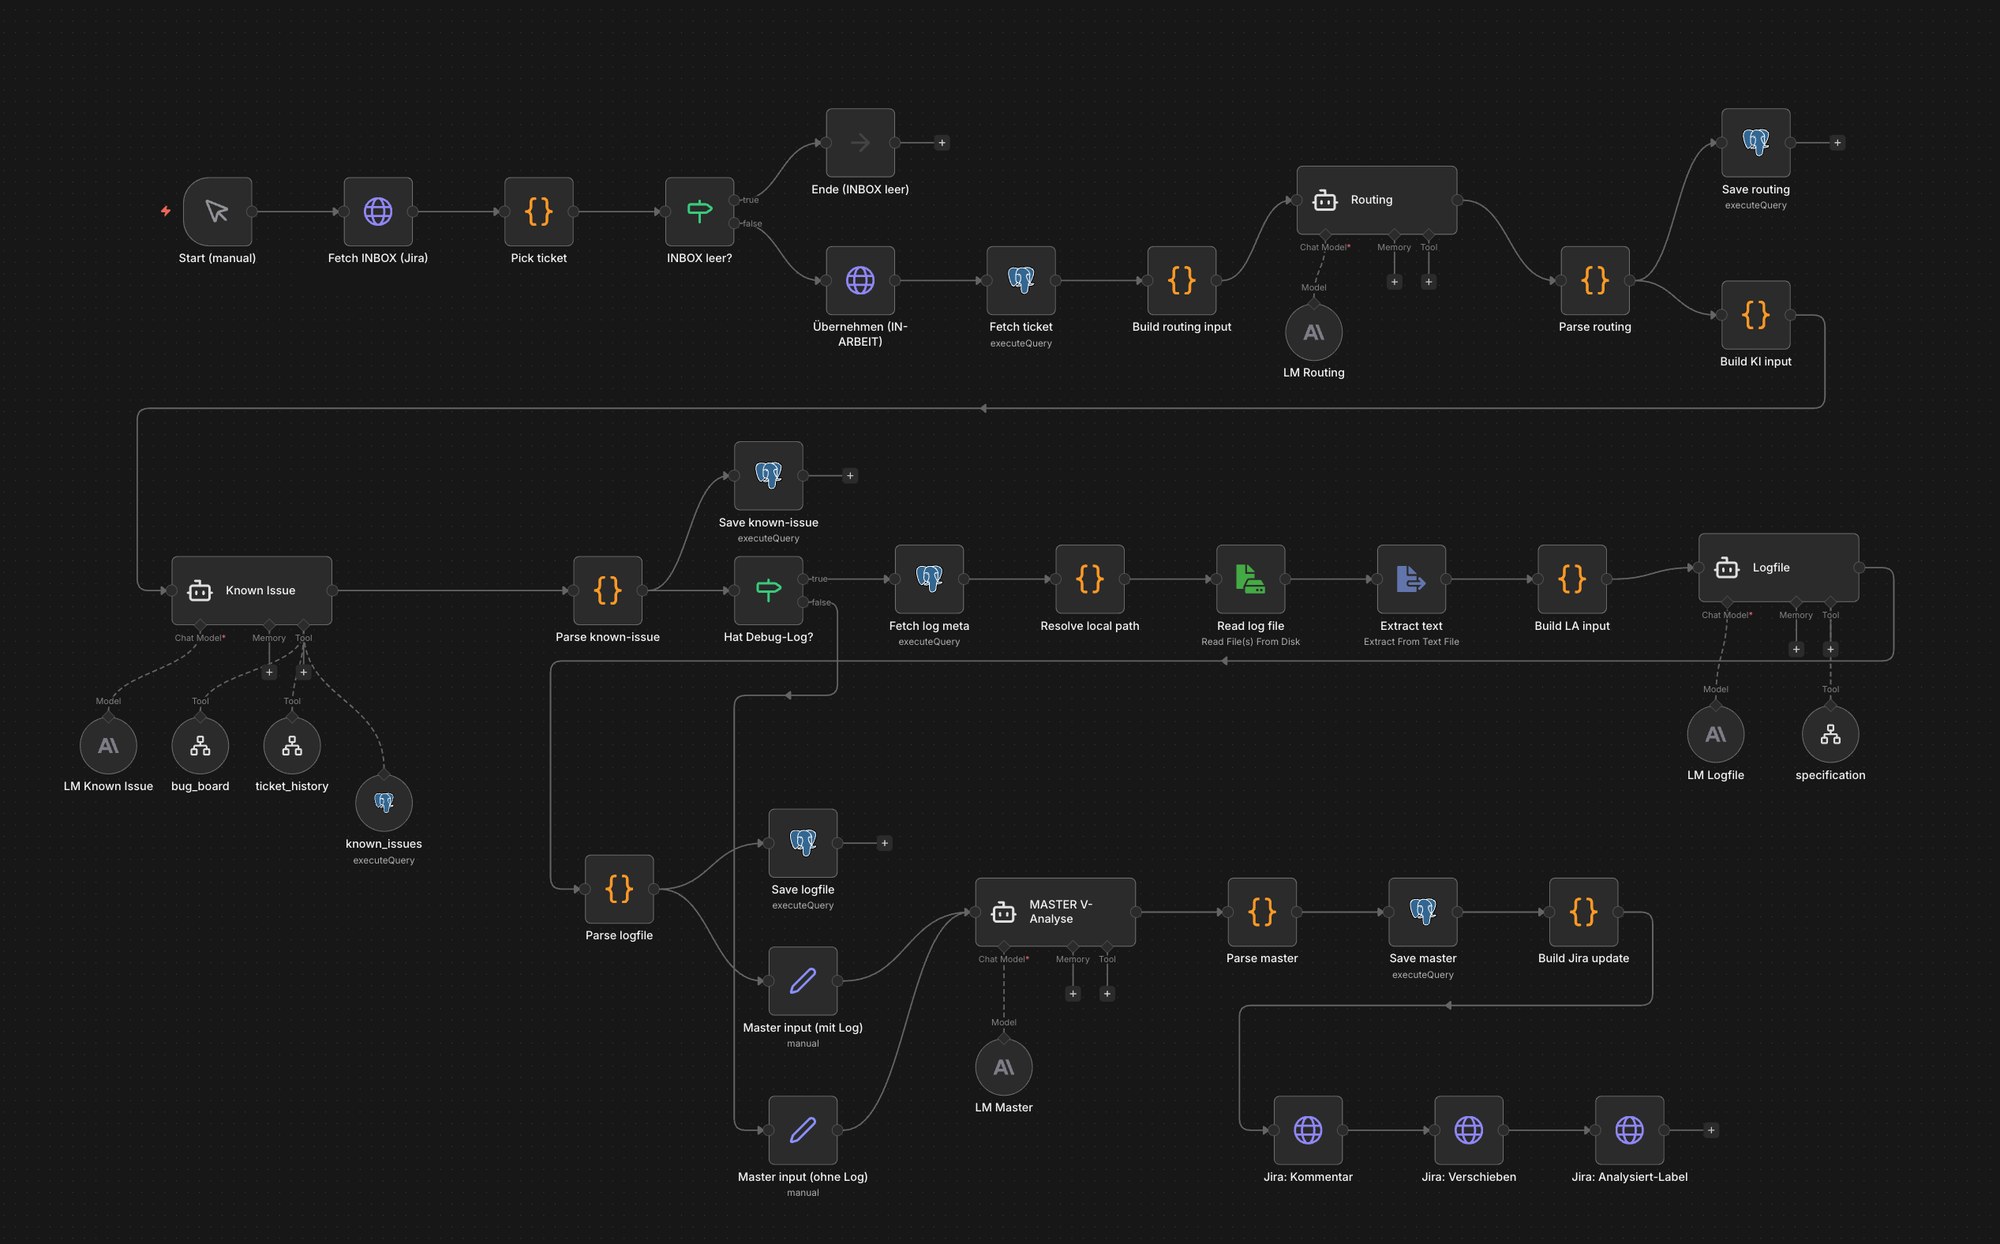
Das Team arbeitet direkt auf dem Jira-Board, wie es auch Menschen tun würden: Ticket übernehmen («in Arbeit»), Analyse als Kommentar mit allen Belegen schreiben, in die passende Spalte verschieben und als analysiert markieren. Bestätigter Fehler → Team-Spalte. Kein Defekt → erledigt. Fehlende Daten → zurück mit konkreter Rückfrage.
Dazu kommt ein selbst gebautes Dashboard mit zwei Ansichten: ein Blick in den Kopf jedes Agenten – was er bekommen, gefunden und geantwortet hat – und eine Ticket-Übersicht, die auf einen Blick zeigt, wer als Nächstes handeln muss.
Mein Beitrag
Konzeption des Agenten-Teams und seiner Regeln gegen das Erfinden von Fakten, Aufbau der fiktiven Produktwelt samt Testdaten und Fallen-Tickets, Umsetzung der Pipelines in n8n, Anbindung von Jira Cloud und PostgreSQL, Prompt-Design der Agenten sowie Entwicklung des Dashboards.
Technologien im Detail
| Technologie / Technik | Einsatz |
|---|---|
| n8n (Workflow-Automation) | Rückgrat beider Pipelines: Agenten, Werkzeuge, Verzweigungen und Jira-Aktionen als sichtbarer Ablauf. |
| Claude (Anthropic API) | Das Sprachmodell hinter den Agenten – jeder mit eigenem Auftrag, eigenem Ausgabeformat und eigenen Verboten. |
| Prompt-Design mit Verboten | Belegpflicht, Vermutung ≠ Fakt, Zuversicht maximal 90 %, «unklar» als gültige Antwort. |
| Werkzeuge pro Agent (Tool Use) | Agenten rufen Teil-Abläufe als Werkzeuge auf: Fehler-Board, Ticket-Historie, bekannte Fehler, Spezifikation. Jeder sieht nur seine eigenen. |
| Prüfer ohne Sprachmodell | Sollwert-Vergleiche mit Code und SQL statt Bauchgefühl. |
| Strukturierte JSON-Übergaben | Jeder Agent liefert einen Datensatz in fester Form – Aussagen ohne Belegfelder sind nicht vorgesehen. |
| Jira Cloud REST API | Tickets lesen, Spalten wechseln, Kommentare und Labels schreiben – direkt auf dem echten Board. |
| PostgreSQL | Spezifikationen pro Firmware-Version, bekannte Fehler und das Protokoll aller Agenten-Läufe. |
| Node.js-Dashboard | Blick in den Kopf jedes Agenten und Ticket-Übersicht nach Handlungsbedarf. |